8 von 8
Fragen ohne Grundlage abgelehnt, statt geraten
acht bewusst außerhalb der Unterlagen liegende Fragen; der Wortlaut jeder Antwort steht in der Messdatei
XICBOT wird auf Ihre Website, Ihre Dokumente, PDFs, FAQ und Preislisten trainiert. Seine Antworten entstehen aus nummerierten Auszügen genau dieser Quellen; trägt kein Auszug die Antwort, sagt der Assistent, dass dazu nichts hinterlegt ist, statt zu raten, und die Frage wird als Lücke vermerkt.
Der Assistent lernt aus Ihren Inhalten. Dazu gehören Ihre Website, Dokumente, PDFs, häufige Fragen und Preislisten. Seine Antworten baut er aus Teilen dieser Quellen. Findet er dort keine Antwort, soll er keine geben. Dann sagt er, dass dazu nichts hinterlegt ist. So rät er in der Regel nicht. Sie können das kostenlos mit Ihren Inhalten testen.
Kostenlose Demo anfordern Preise ansehen
Besucherin:Ab welcher Stückzahl gilt bei Ihnen der Staffelpreis?
Assistent:Die Staffel beginnt bei 50 Stück. Die Zahl steht so in der Preisliste — ich gebe sie unverändert weiter und rechne sie nicht um.
Besucherin:Und wenn ich zwei Varianten mische — zählt das zusammen?
Assistent:Dazu steht nichts in der hinterlegten Wissensbasis. Trägt kein Auszug die Antwort, sage ich genau das; eine Schätzung wäre an dieser Stelle geraten.
Besucherin:Erfährt der Betrieb davon?
Assistent:Ja. Eine Antwort ohne eine einzige verwendete Fundstelle wird als Wissenslücke vermerkt und meldet sich weiter. Der Wortlaut Ihrer Frage wird dabei nicht zusätzlich gespeichert, und unter zwölf Zeichen entsteht gar kein Eintrag.
Selbst fragen, Assistent dieser Website
Automatischer Assistent8 von 8
Fragen ohne Grundlage abgelehnt, statt geraten
acht bewusst außerhalb der Unterlagen liegende Fragen; der Wortlaut jeder Antwort steht in der Messdatei
Ein KI-Chat-Assistent ist nur so gut wie das Wissen, auf dem er antwortet. Ein generischer Baukasten-Bot mit starren Menübäumen weiß nichts über Ihr Geschäft und schickt Besucher schnell in eine Sackgasse. XICBOT geht den umgekehrten Weg: Wir trainieren den Assistenten auf Ihre eigenen Inhalte, damit er Ihr konkretes Angebot, Ihre Preise, Ihre Öffnungszeiten und Ihre häufigen Fragen kennt. Diese trainierte Wissensbasis ist das Fundament für alles Weitere, vom Website-Assistenten, der Besucherfragen beantwortet, bis zum Support-Assistenten, der Anfragen aus FAQ und Hilfe-Artikeln löst. Und weil seine Antworten an Ihre Quellen gebunden sind, antwortet der Assistent aus Ihren Inhalten statt ins Blaue hinein.
Bevor der Assistent eine einzige Frage beantwortet, sammeln wir Ihre vorhandenen Inhalte und machen sie für ihn nutzbar. Je vollständiger die Wissensbasis, desto weniger Fragen bleiben offen und desto seltener muss an einen Menschen übergeben werden. Die folgenden Quellen fließen typischerweise in das Training ein, und weitere lassen sich jederzeit ergänzen.
Ihre Startseite, Leistungsseiten, Über-uns-Seite und Kontaktangaben. Der Assistent kennt Ihr Angebot so, wie es auf der Website steht, und führt Besucher gezielt zur passenden Unterseite.
Handbücher, Datenblätter, Broschüren und interne Unterlagen. Der Assistent fasst zusammen, was in Ihren Dokumenten steht, und beantwortet Detailfragen aus dem PDF, ohne dass Besucher es selbst durchsuchen müssen.
Ihre häufigen Fragen, Anleitungen und Hilfe-Artikel. Wiederkehrende Fragen beantwortet der Assistent direkt aus Ihrem FAQ, rund um die Uhr und in der Sprache der Besucherin.
Preise, Tarife, Verfügbarkeiten, Standorte und Öffnungszeiten. So beantwortet der Assistent genau die Fragen, die sonst zum Telefon oder zur E-Mail führen, verlässlich aus Ihren aktuellen Angaben.
Auf Wunsch binden wir eine interne Wissensdatenbank oder ein Hilfe-Center an. Der Assistent antwortet dann aus demselben Bestand, den auch Ihr Team nutzt, und bleibt damit nah an Ihren offiziellen Auskünften.
Seine Antworten sind an Ihre eigenen Inhalte gebunden. Der Assistent antwortet aus dem, was in Ihren Quellen steht, statt frei zu formulieren, und kann auf die Fundstelle verweisen, damit Besucher die Herkunft nachvollziehen.
Sechs Zeilen, im Kern aber vier Quellenarten: Text, Datei, Website und FAQ. Was darüber hinaus als Quelle gilt, kommt über eine dieser vier herein — eine eigene Anbindung je Fremdsystem ist damit nicht gesagt. Wir schreiben das hier so genau, weil der Unterschied sonst erst beim Einrichten auffällt.
2 670
Abschnitte aus 70 Dokumenten in der eigenen Wissensbasis
der Bestand des Assistenten, der auf dieser Seite antwortet
Art, Bezeichnung und Inhalt sind die Felder einer Quelle; hochgeladene Dateien folgen der Frist, die für Ihr Konto gilt.
Die Antwortprobe stellt eine Frage und zeigt, welche Quelle sie deckt.
Frage-Antwort-Paare legen dort fest, wo eine Formulierung nicht abweichen soll.
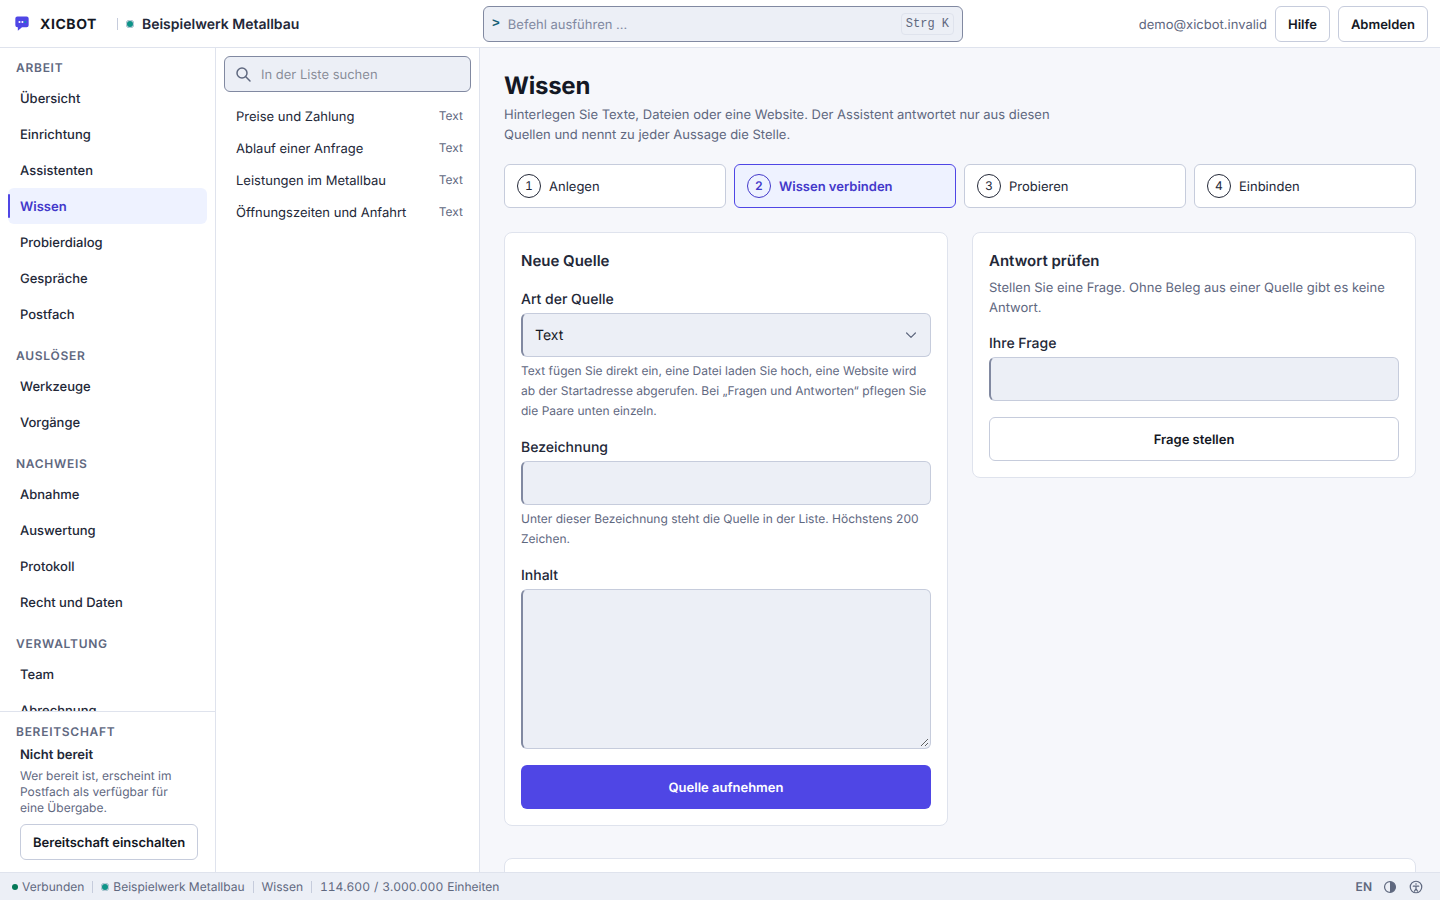
Ein Sprachmodell formuliert auch dann flüssig, wenn ihm die Grundlage fehlt. Deshalb gibt bei XICBOT der Lauf davor das Material vor: Fünf Auszüge aus Ihren Quellen gehen nummeriert in die Anfrage, jeder in einem eigenen Rahmen mit Dokumenttitel. Die Anweisung verlangt die Nummer in eckigen Klammern, und eine Fundstelle zählt erst als verwendet, wenn ihre Nummer im Antworttext steht. Kommt eine Antwort ohne eine einzige verwendete Nummer zurück, wird sie als Lücke vermerkt. Trägt kein Auszug die Antwort, sagt der Assistent dem Besucher in der Regel, dass dazu nichts in der hinterlegten Wissensbasis steht. Das ist kein Ausweichen, sondern genau die Stelle, an der ein Assistent ohne Quellenbindung anfangen würde zu raten.
Nummerierte Auszüge statt freier Formulierung
Nach dem Modell läuft eine zweite Prüfung. Harte Aussagen im Entwurf werden gegen das Auszugsmaterial gegengelesen; was dort nirgends steht, wird durch einen Platzhalter ersetzt, und die Richtigstellung erreicht den Besucher als eigenes Ereignis. War überhaupt kein Auszugsmaterial vorhanden, bleibt der Text unangetastet — eine Aussage über ein leeres Regal wäre keine Prüfung, sondern eine Behauptung. Irren kann ein Assistent trotzdem. Die Bindung an Ihre Quellen, die genannte Fundstelle und die jederzeit mögliche Übergabe an Ihr Team halten den Spielraum dafür klein.
42 von 48
Antworten mit Angabe der Quelle
Fragen, deren Antwort in der Wissensbasis steht; sechs blieben ohne Quellenangabe
Die trainierte Wissensbasis ist nicht nur ein Nachschlagewerk. Sie ist die Grundlage dafür, dass der Assistent Besucher berät, weiterleitet und für Sie aktiv wird. Aus demselben Wissen liest er aus (Read) und handelt (Actions), immer im Rahmen der Freigaben, die Sie festlegen. Welche Aktionen dabei möglich sind, zeigt die Tool-Steuerung.
Besucher:Kommen Sie auch ins Umland?
Assistent:Dazu steht nichts in der hinterlegten Wissensbasis.
Besucher:Auf der Website steht doch ein Abschnitt Einsatzgebiet.
Assistent:Der Abschnitt liegt vor, teilt aber kein Wort mit Ihrer Frage. Gesucht wird über Wörter, nicht über Bedeutungen — über „Umland“ finde ich ihn deshalb nicht. Und die Abdeckung wird je Abschnitt gemessen: Zwei Treffer, die je eine Hälfte tragen, ergeben zusammen keine volle Abdeckung.
Besucher:Lässt sich das abstellen?
Assistent:Für genau solche Fälle hinterlegt der Betrieb ein gepflegtes Frage-Antwort-Paar mit den Wörtern, die Besucher wirklich benutzen. Dessen Wortlaut geht unverändert heraus, ohne Modellaufruf.
Eine geänderte Preisliste wirkt nicht im selben Augenblick, und wir schreiben es auch nicht so. Eine Website-Quelle trägt ein Abrufintervall — im Haus sieben Tage, einstellbar von einem Tag bis zu einem Jahr, und der Wert null heißt: gar nicht. Ein täglicher Lauf sucht heraus, was daran fällig ist. Als veraltet gilt eine Quelle erst, wenn mehr als das Doppelte ihres Intervalls vergangen ist, mindestens aber vierzehn Tage. Beim Abruf fragt der Dienst mit ETag und Änderungsdatum nach: Meldet Ihr Server unverändert, wird nichts neu zerlegt. Und wer eine Antwort aus einer veralteten Quelle bekommt, stößt damit im Hintergrund eine Auffrischung an, ohne dass die laufende Antwort darauf wartet.
Ein Lauf schreibt in die nächste Fassung, nicht in die laufende
Geschrieben wird nicht in den Bestand, der gerade antwortet, sondern in die nächste Fassung; umgeschaltet wird erst am Ende und nur, wenn sie sich vom alten Stand unterscheidet. Scheitert der Lauf, bleibt der Zeiger stehen und der alte Stand antwortet weiter. Hat ein Lauf nichts geschrieben, löscht er auch nichts — sonst würde eine Wartungsseite Ihre Wissensbasis leeren und Erfolg melden. Fünf Fassungen bleiben liegen; ein Rücksprung verwirft alles darüber und ist nach vorn verlustbehaftet. Ein Dokument, das sich nicht geändert hat, wird übersprungen, erkannt am Abdruck seines Textes statt an seinem Datum, und eine Seite, die zum Entwurf geworden ist, verliert ihre Abschnitte.
Sie müssen kein Wissen aufbereiten und keine Skripte schreiben. Wir übernehmen die Einrichtung und führen Sie in überschaubaren Schritten durch das Training, von der ersten Quellensammlung bis zum laufenden Aktuellhalten. Am Anfang steht ein Blick auf Ihre vorhandenen Inhalte: welche Quellen vorliegen, wie viel davon Text trägt und welche Fragen sich damit heute schon beantworten lassen.
Wir sichten Ihre vorhandenen Inhalte: Website und Unterseiten, PDFs und Datenblätter, FAQ, Preislisten, Öffnungszeiten und, falls vorhanden, Ihre interne Wissensdatenbank. Sie entscheiden, welche Quellen einfließen und welche außen vor bleiben. Zusätzliches Wissen können Sie uns formlos als Text oder Datei geben.
Aus diesen Quellen trainieren wir Ihren Assistenten. Wir strukturieren die Inhalte so, dass er passende Antworten findet, verwandte Themen verknüpft und auf die richtige Fundstelle verweisen kann. Der Assistent lernt Ihr Angebot, Ihre Begriffe und Ihre häufigen Fragen kennen.
Wir testen typische Fragen Ihrer Kundschaft, prüfen die Antworten gegen die Quellen und schärfen Formulierungen und Tonfall. Gemeinsam legen wir fest, wann der Assistent an einen Menschen übergibt und welche Themen er bewusst nicht selbst beantwortet. So passt der Assistent zu Ihrem Haus.
Vor dem Livegang läuft ein Probensatz: bis zu 50 Fragen, jede in einem eigenen Gespräch und über denselben Weg wie ein echtes Gespräch. Geurteilt wird ohne Modell auf drei nachrechenbaren Füßen — Pflichtbegriffe, verbotene Begriffe und wörtliche Überdeckung mit der Antwort. Eine Zeile, die überhaupt keine Antwort erhalten hat, wird als Fehler geführt und bleibt aus jeder Quote heraus.
Ändern sich Preise, Öffnungszeiten, Leistungen oder Dokumente, aktualisieren wir die Wissensbasis, ohne den Assistenten neu aufzubauen. Neue Quellen kommen hinzu, überholte fallen weg. So bleibt der Assistent auf demselben Stand wie Ihre Website und Ihr Team.
Ein neuer Assistent steht auf Entwurf, auch der, den der Einrichtungsassistent vorschlägt: Die Maschine schlägt vor, der Mensch nimmt an. Erst mit Ihrer Annahme gilt ein Vorschlag als übernommen, und werbende Absolutheiten fallen aus einem maschinellen Vorschlag heraus und stehen stattdessen im Bericht.
Ein Wort zur Grenze dieser Abnahme: Sie misst, sie sperrt nicht. Es gibt keine Bedingung, die das Umschalten auf aktiv an ein Ergebnis des Probensatzes bindet. Deshalb steht das Ergebnis vor dem Umschalten und nicht danach — die Entscheidung bleibt bei Ihnen.
Der Weg von der Adresse bis zur ersten Antwort besteht aus fünf Schritten, und keiner davon läuft im Browser des Besuchers. Er steht hier nicht, weil er schön aussieht, sondern weil jeder Schritt einen Deckel hat, den Sie kennen sollten, bevor Sie eine große Quelle anlegen.
Beim Anlegen prüft ein Wächter das Ziel, bevor irgendetwas abgerufen wird: nicht auflösbare Namen, fremde Schemata und nicht öffentlich erreichbare Ziele werden abgelehnt, jedes Weiterleitungsziel erneut. Eine Website wird danach nicht im laufenden Aufruf gelesen, sondern als Auftrag eingereiht; Text und Datei zerlegt derselbe Aufruf direkt, eine FAQ-Sammlung ist ohne Abruf gleich fertig.
Der Wissensbegeher arbeitet eine Warteschlange ab: Start-Adresse, Sitemap, der Bestand des letzten Laufs, dann Verweise aus dem Seitentext. Gelesen werden nur HTML und reiner Text, der Körper in Stücken — die Längenangabe des fremden Servers ist eine Behauptung, keine Messung. Ist der Deckel erreicht, bricht der Lauf ab und vermerkt, wie viele Verweise offen geblieben sind.
Der Text wird zuerst an Überschriften getrennt, dann an Satzgrenzen. Ziel sind 800 Zeichen mit 120 Zeichen Überlappung, bei Dateien 1400 mit 200; je Quelle lässt sich das zwischen 200 und 4000 Zeichen stellen. Bei 1600 Zeichen wird hart geschnitten, damit kein Abschnitt unbegrenzt wächst. Eine geänderte Abschnittsgröße wirkt erst beim nächsten Lauf, denn am Inhalt hat sich nichts geändert.
Jeder Abschnitt bekommt bis zu 14 Stichwörter und bis zu 4 Fragen, die zusammen mit der Überschrift in den Suchtext zurückgeschrieben werden. Kein Modell ist daran beteiligt: Jedes Stichwort steht im Abschnitt selbst, und Fragen entstehen nur dort, wo eine Überschrift vorliegt und die Sprache erkannt wurde.
Zuletzt entsteht je Abschnitt ein Profil aus 256 Stellen, gebildet aus Wörtern, Wortpaaren und Zeichenfolgen — kein neuronales Verfahren, kein fremder Dienst, keine Grafikkarte. Bis dieser Schritt durch ist, sucht der Assistent allein über den Volltext. Danach schaltet die neue Fassung um, und nur dann, wenn sie sich vom alten Stand unterscheidet.
Zwei Deckel sind im Alltag die, an die man stößt: höchstens 25 Seiten je Lauf und 200 Quellen je Frischehaltungslauf. Beide brechen nicht still ab, sondern vermerken, dass gedeckelt wurde. Eine Quelle, für die noch ein Auftrag läuft, wird übersprungen statt doppelt gelesen.
Der Preis hängt an Menge und Zustand Ihrer Quellen, nicht an der Zahl der Fragen, die Besucher stellen. Eine gepflegte Website mit sauberen Überschriften ist schneller aufgenommen als ein Ordner gescannter PDFs: Ohne Textebene liefern die gar nichts und müssen vorher ersetzt werden. Deshalb steht am Anfang der Blick auf den Bestand und nicht die Paketwahl.
ab 49 € pro Monat netto
Mindestlaufzeit: keine, monatlich kündbar
Alle Preise netto zzgl. USt. Quelle: Preisliste XICBOT, Stand 11.09.2026
Ein Assistent mit eigener Wissensbasis startet im Paket Start ab 49 € pro Monat netto für den laufenden Betrieb, Hosting in Deutschland, Pflege und Updates inklusive. Die einmalige Einrichtung mit individuellem Training und Einbindung beginnt ab 990 € netto. Größere Wissensbestände, Shop-Anbindung oder eine interne Wissensdatenbank bilden wir im Paket Pro oder Individuell ab; eine Übersicht aller Pakete finden Sie unter Preise. Laufende Leistungen sind einzeln buchbar und monatlich kündbar, eine Mindestlaufzeit gibt es nicht.
Wir sichten Website, PDFs und FAQ und sagen Ihnen sachlich, welche Fragen sich damit bereits beantworten lassen und an welchen Stellen noch Lücken bleiben.
Der Unterschied zwischen einem generischen Chatbot und einem auf Ihre Wissensbasis trainierten Assistenten zeigt sich im Alltag, sobald eine Frage vom vorgesehenen Pfad abweicht. Die Gegenüberstellung macht deutlich, wo die Grenze zwischen Sackgasse und echter Antwort verläuft.
Wissenslücken sichtbar machen und schließenFragen, auf die der Assistent noch keine Antwort in Ihrer Wissensbasis findet, sind bares Wissen für Sie. Über die Gesprächsanalyse sehen Sie, welche Themen häufig gefragt werden und wo Inhalte fehlen, und ergänzen die Wissensbasis gezielt. Wie Ihre Inhalte dabei geschützt und wo sie verarbeitet werden, lesen Sie unter Datenschutz & Hosting.
Welche Inhalte in die Wissensbasis gehören und wie sie aktuell bleiben, beschreibt Wissensbasis aufbauen im Detail. Warum die Quellenbindung technisch der wirksamste Hebel gegen falsche Antworten ist, erklärt Halluzinationen vermeiden. Wie der Assistent dabei in Ihrem Ton bleibt, zeigt KI-Assistent mit eigener Markenstimme.
Die Fragen hier drehen sich um Herkunft und Pflege des Wissens. Was der Assistent über das Antworten hinaus tun darf, steht unter Tool-Steuerung; wo Ihre Inhalte verarbeitet werden, unter Datenschutz & Hosting.
Trainiert wird nichts: Ihre Inhalte gehen in eine Wissensbasis, aus der die Antwort zur Laufzeit gesucht wird. Vier Quellenarten stehen zur Wahl — freier Text, Datei, Website und gepflegte Frage-Antwort-Paare. Ein Website-Lauf liest höchstens 25 Seiten, hält sich an die robots.txt, nimmt nur HTML und reinen Text und folgt keinem Verweis auf eine fremde Adresse; Seiten mit noindex zählen als Entwurf und liefern gar keine Abschnitte. Dateien bis 10240 KB werden zerlegt, ein PDF über seine vorhandene Textebene. Welche Quelle eingeht und wann sie erneut gelesen wird, entscheiden Sie je Eintrag. Mehr unter Wissensbasis.
Je Antwort holt der Gesprächslauf fünf Treffer aus Ihrer Wissensbasis und baut daraus die Auszüge, auf die sich der Assistent stützen darf. Trägt keiner der Treffer die Frage, ist er angewiesen, nicht zu raten, sondern zu sagen, dass dazu nichts in der hinterlegten Wissensbasis steht. Parallel wird die Frage als Wissenslücke vermerkt; ab dem Paket Pro zeigt die Liste der Wissenslücken bis zu 50 Fälle und ist der Arbeitsvorrat für die nächste Pflegerunde. Auf Wunsch übergibt der Assistent an einen Menschen: Zustandswechsel, Eintrag im Postfach und Benachrichtigung entstehen in einem Zug, der Verlauf hängt an. So bleibt eine offene Frage sichtbar, statt im Gespräch zu verschwinden. Mehr beim Support-Assistenten.
Der Spielraum dafür ist eng gezogen. Zu jeder Frage gehen höchstens fünf Suchtreffer aus Ihrer Wissensbasis, dazu Ihre Textbausteine, nummeriert an das Modell, und belegte Antworten nennen die Auszüge, auf die sie sich stützen. Zahlen, Preise und Fristen, die nicht in Ihren Quellen stehen, ersetzt der Assistent durch einen Hinweis. Findet die Suche nichts oder verweigert das Modell, sagt er, dass dazu nichts in der hinterlegten Wissensbasis steht — und der Fall wird als Wissenslücke protokolliert, ebenso eine Antwort ohne benutzten Auszug. Kontaktdaten, Aktenzeichen und Termine zu erfinden oder sich als Mensch auszugeben, verbieten ihm seine Regeln. Ganz ausschließen lässt sich ein Irrtum bei keinem Sprachmodell; deshalb die Quellenbindung, die sichtbare Fundstelle und die Übergabe an einen Menschen.
Jede Quelle hat ihre eigene Auffrischfrist: Die Hausfrist sind 7 Tage, einstellbar zwischen 1 und 365, und der Wert 0 heißt ausdrücklich nie. Ein täglicher Lauf reiht die fälligen Quellen ein und liest sie erneut; abgerufen wird bedingt über ETag und Last-Modified, eine unveränderte Seite kostet also keinen neuen Aufbau. Als veraltet gilt eine Quelle erst, wenn seit der letzten Prüfung mehr als das Doppelte ihrer Frist vergangen ist, mindestens aber 14 Tage. Jeder Indexlauf schreibt in eine neue Fassung und schaltet erst am Ende um, fünf Fassungen bleiben aufbewahrt. Auf Wunsch übernehmen wir das Pflegen als Teil des laufenden Betriebs. Mehr unter Wissensbasis.
Ja, solange das Dokument eine Textebene hat. Dateien bis 10240 KB nimmt die Wissensbasis entgegen und zerlegt sie in überlappende Abschnitte, damit ein Absatz nicht mitten im Satz endet; ein PDF wird über seine vorhandene Textebene gelesen. Ein eingescanntes Blatt ohne Textebene liefert bewusst nichts — Texterkennung aus dem Bild gibt es nicht, und der Grund steht als Meldung an der Quelle, statt still zu fehlen. Zur Frage gehen dann höchstens fünf Suchtreffer, dazu Ihre Textbausteine, nummeriert an das Modell, und belegte Antworten nennen die Auszüge, auf die sie sich stützen. Für Preise, Konditionen oder Fristen, die genau stimmen müssen, ist das gepflegte Frage-Antwort-Paar der bessere Ort: Es geht wortgleich hinaus. Mehr unter Wissensbasis.
Der laufende Betrieb beginnt im Paket Start ab 49 € pro Monat netto inklusive Hosting in Deutschland, Pflege und Updates, die einmalige Einrichtung mit individuellem Training ab 990 € netto. Start fasst zehn Wissensquellen und 200 Dokumente, Pro ab 2.900 € netto Einrichtung und 149 € pro Monat netto fasst 50 Quellen und 2.000 Dokumente, Individuell ab 4.900 € netto Einrichtung 250 Quellen und 20.000 Dokumente. Als Quelle dienen Text, Datei, Website oder eine Frage-Antwort-Sammlung. Belegte Antworten nennen ihre Quelle; eine Antwort ohne benutzten Auszug wird als Lücke vermerkt. Details unter Wissensbasis und Preise. Alle Leistungen sind monatlich kündbar, eine Mindestlaufzeit gibt es nicht.
Im Bereich Wissen Ihres Kontos, je Quelle mit Zeitpunkt. Dort steht auch, ob eine Begehung gedeckelt wurde und wie viele Verweise offenblieben — ohne diese Zahl stünde die Quelle danach auf fertig, als wäre sie vollständig gelesen. Solange nichts gemessen wurde, bleibt das Feld leer und wird nicht als Null ausgegeben. Jede Quelle trägt außerdem ihre Auffrischfrist; als veraltet gilt sie erst, wenn seit der letzten Prüfung mehr als das Doppelte dieser Frist vergangen ist, mindestens aber 14 Tage. Ein bedingter Abruf über ETag und Last-Modified kann dabei ergeben, dass sich nichts geändert hat. Das alles ist unabhängig von Produktänderungen und die häufigste Erklärung für veränderte Antworten.
Ja. Eine Website genügt für die ersten Antworten. Der Crawler folgt dabei den Vorgaben Ihrer robots.txt und nimmt je Lauf eine begrenzte Zahl von Seiten auf; daraus entstehen Abschnitte, aus denen der Assistent belegt antwortet. Ergänzen lässt sich jederzeit: Es gibt vier Quellarten — Text, Datei, Website und Frage-Antwort-Sammlung. Der Assistent muss dafür nicht neu aufgebaut werden: Jeder Indexlauf schreibt eine neue Fassung und schaltet erst am Ende um, und ein gescheiterter Lauf lässt den alten Stand weiterantworten, statt eine Lücke zu hinterlassen.
Sie, wenn Sie möchten: Die Oberfläche zeigt Quellen, Dokumente und Gespräche, und eine geänderte Quelle wird neu eingelesen. Jede Quelle hat eine eigene Auffrischungsfrist — voreingestellt sind 7 Tage, einstellbar zwischen 1 und 365, und der Wert 0 heißt ausdrücklich: nicht automatisch. Ein Lauf am frühen Morgen arbeitet die fälligen Quellen ab; als veraltet gilt eine Quelle erst, wenn seit der letzten Prüfung mehr als das Doppelte ihrer Frist vergangen ist, mindestens aber 14 Tage. Unveränderte Seiten werden dabei übersprungen, und ein Lauf, der nichts geschrieben hat, löscht nichts — sonst räumte eine Wartungsseite Ihre Wissensbasis ab. Die Auswertung zeigt, welche Fragen häufig kommen und wo eine Antwort fehlt. Wer das nicht selbst tun will, gibt es an uns.
Eine Frage, die hier oft folgt, beantwortet der Bestand selbst: Wann eine Quelle zuletzt gelesen wurde, steht je Quelle mit Zeitpunkt im Bereich Wissen Ihres Kontos. Das ist die häufigste Erklärung dafür, dass eine Antwort sich verändert hat, und sie liegt näher als jede Vermutung über das Modell.
Kostenlose Demo mit Ihren Inhalten
Wir trainieren XICBOT auf Ihre Website, Ihre Dokumente und Ihre FAQ und zeigen Ihnen, wie der Assistent gebunden an Ihre eigenen Quellen antwortet. Unverbindlich und ohne Verkaufsdruck. Demo besprechen
Nennen Sie uns Ihre Website-Adresse und welche Fragen Ihre Kundschaft am häufigsten stellt. Auf Wunsch trainieren wir einen Test-Assistenten auf Ihre Inhalte, damit Sie die Quellenbindung selbst erleben. Telefonisch erreichen Sie uns unter 05123 9579000.